
技术方案.md 44 KB
知识图谱 Agent 问答系统 —— 技术方案
状态:已定稿,作为后续开发的唯一权威依据;任何变更需同步更新本文档。 最后更新:2026-08-14(与当前 15 类数据模板、两阶段构建器、检索层实现保持一致)
1. 项目概述
将市场部、财务部、人事部、运营部、采购部的业务台账以「项目」为核心联通为知识图谱, 通过 LLM Agent 提供自然语言问答,答案必须可溯源到原始数据。
1.1 数据范围与体量(实测)
| 数据 | 体量 | 来源 |
|---|---|---|
| 项目 | 305(214 服务中已匹配 + 34 服务中未体现 + 57 历史;121 有金蝶编码) | 市场部项目梳理表 + 项目管理表 + 业务大表 |
| 人员 | 256~281(工号 KWL 前缀) | 人事部考勤/排班表 |
| 设备 | 858 | 运营部设备台账(青浦工业园区、徐汇环境监测中心) |
| 考勤记录 | 882(员工×月) | 人事部考勤表 |
| 排班记录 | 986(员工×月) | 人事部排班文件(48 个组织代码) |
| 财务收费明细 | 262 行(合同×月) | 财务部收费进程表 |
| 业务大表(项目扩展) | 282 行(121 父项目 + 80 子项目 + 81 服务点) | 龚天晓字段补充:业态/区域/合同明细/从属关系 |
| 项目档案目录 | 165 项目目录 / 623 合同期文件夹 / 276 续签衔接 | E:\申勤物业项目资料(区域→项目→合同期) |
| 档案文档 | 4657 文件(PDF 3415 为扫描件需 OCR、Word 684、Excel 88、图片 241) | 合同/招标/投标/中标通知书/验收等全生命周期 |
| 员工档案 | 全员花名册(五级公司=项目、岗位名称、职级、司龄、组织) | 人事部员工信息.xlsx |
| 岗位编制 | 项目 × 全岗位编制(预算/项目/标准工时/在岗) | 运营部 9-项目岗位编制汇总.xlsx |
| 维保/采购 | 维保合同台账、耗材汇总、固定资产台账 | 采购部常用表格 |
| 岗位薪资标准 | 区域 × 岗位 税前/税后区间 | 各管理处岗位薪资1.xlsx(系统侧参考,不进模板) |
| 人员证书 | 一人多行(华东区域/申勤两 sheet),含 工号/职位/专业类别/证书类别/证书名称 | 合景悠活职称及资格证书管理登记表(2026年第一季度) |
| 数据模板 | 15 类、每份一个数据表(+填写说明),含必填唯一标识与字段依据 | data/templates |
| 测试数据 | 15 类与模板一一对应(16 项目/34 人员/33 考勤/9 证书等) | data/test_data |
| 时间覆盖 | 2026-01 ~ 2026-04(科创含 25.12) | — |
2. 技术选型
| 层 | 选型 | 说明 |
|---|---|---|
| 环境 | uv(pyproject.toml + uv.lock) | Python 3.11+,依赖锁版本 |
| 图存储 | Neo4j 5+(neo4j://127.0.0.1:7687) | 单一全时间图,不做时间切片 |
| LLM | DeepSeek(deepseek-v4-flash,OpenAI 兼容) |
base_url / key / model 存 .env,模型名可配置;SDK:openai |
| 语言 | Python 3.14(当前 venv) | pandas / openpyxl / xlrd / neo4j / python-docx / pypdf / openai |
3. 总体架构
3.1 数据接入与图谱构建
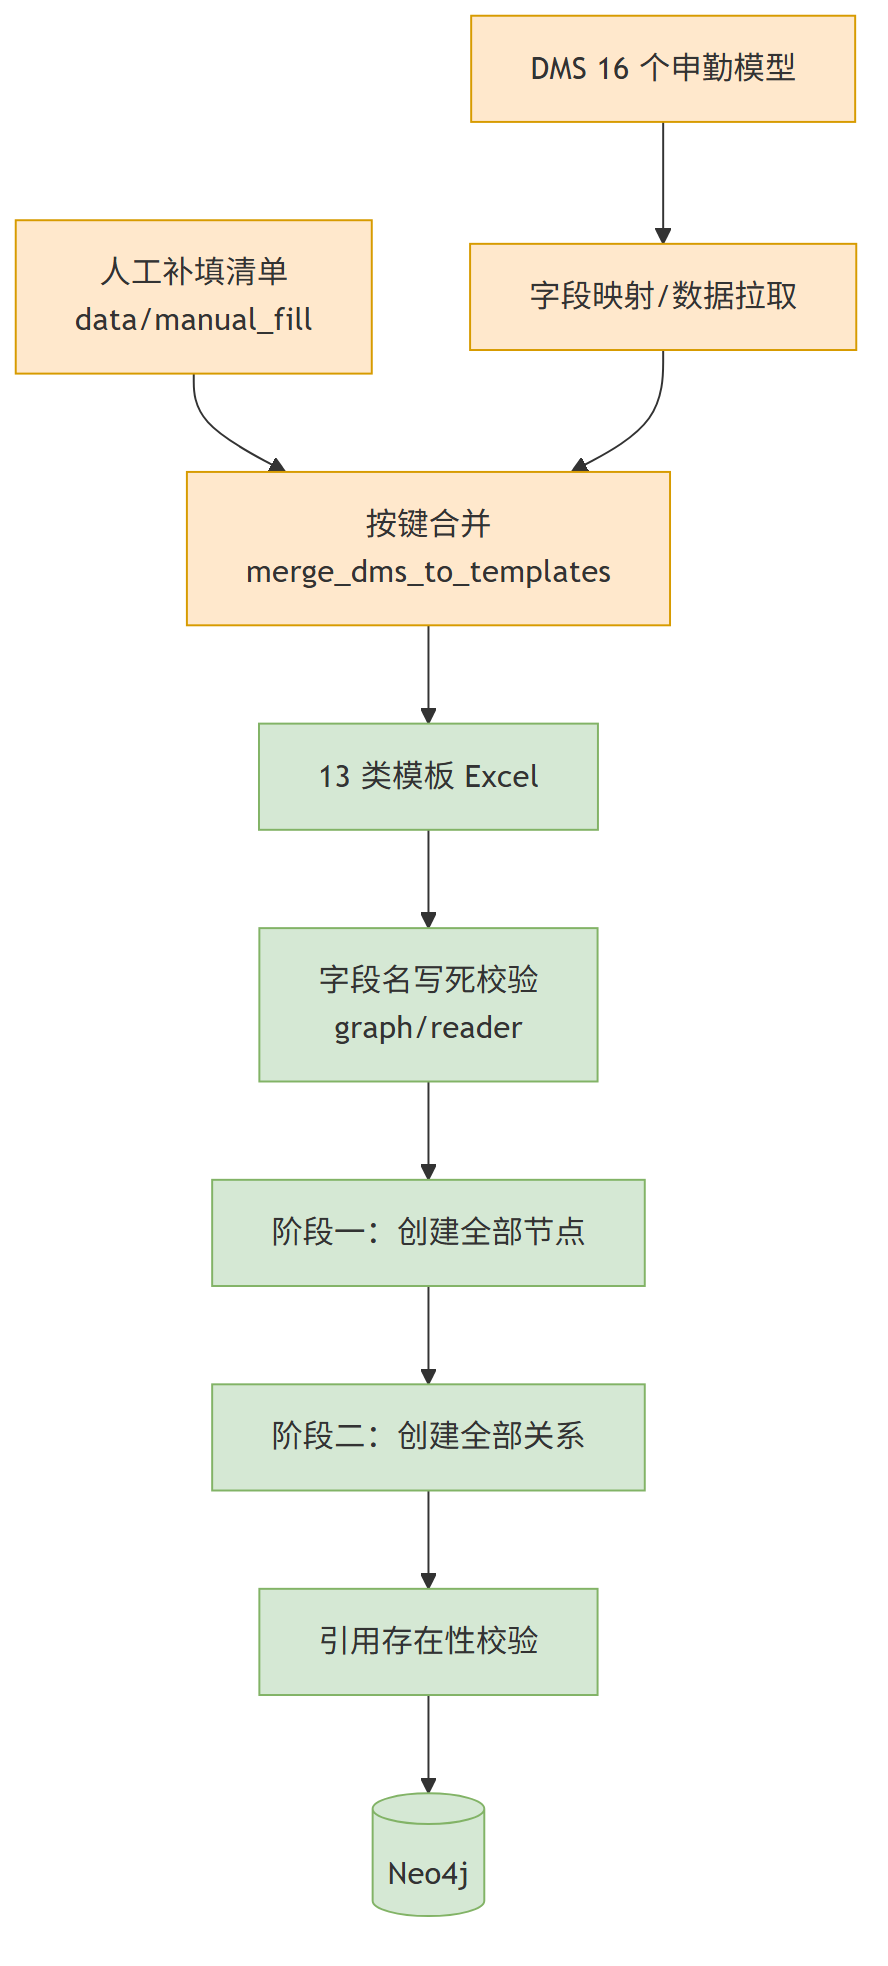
查看 / 编辑 Mermaid 源码
```mermaid graph TB DMS[DMS 16 个申勤模型] --> FETCH[字段映射/数据拉取] MAN[人工补填清单data/manual_fill] --> MERGE[按键合并
merge_dms_to_templates] FETCH --> MERGE MERGE --> TPL[15 类模板 Excel] TPL --> CHECK1[字段名写死校验
graph/reader] CHECK1 --> NODES[阶段一:创建全部节点] NODES --> EDGES[阶段二:创建全部关系] EDGES --> CHECK2[引用存在性校验] CHECK2 --> NEO[(Neo4j)] style DMS fill:#ffe8cc,stroke:#d79b00 style FETCH fill:#ffe8cc,stroke:#d79b00 style MAN fill:#ffe8cc,stroke:#d79b00 style MERGE fill:#ffe8cc,stroke:#d79b00 style TPL fill:#d5e8d4,stroke:#82b366 style CHECK1 fill:#d5e8d4,stroke:#82b366 style NODES fill:#d5e8d4,stroke:#82b366 style EDGES fill:#d5e8d4,stroke:#82b366 style CHECK2 fill:#d5e8d4,stroke:#82b366 style NEO fill:#d5e8d4,stroke:#82b366 ```
状态:🟧 橙色 = 规划中(DMS 模型元数据已识别,但数据值拉取脚本、
merge_dms_to_templates合并脚本、人工实际填写补填清单尚未完成);🟩 绿色 = 已实现(15 类模板与测试数据、graph/reader字段名写死校验、两阶段构建、引用存在性校验,测试数据端到端跑通)。
3.2 问答 Agent 流程(LangGraph)
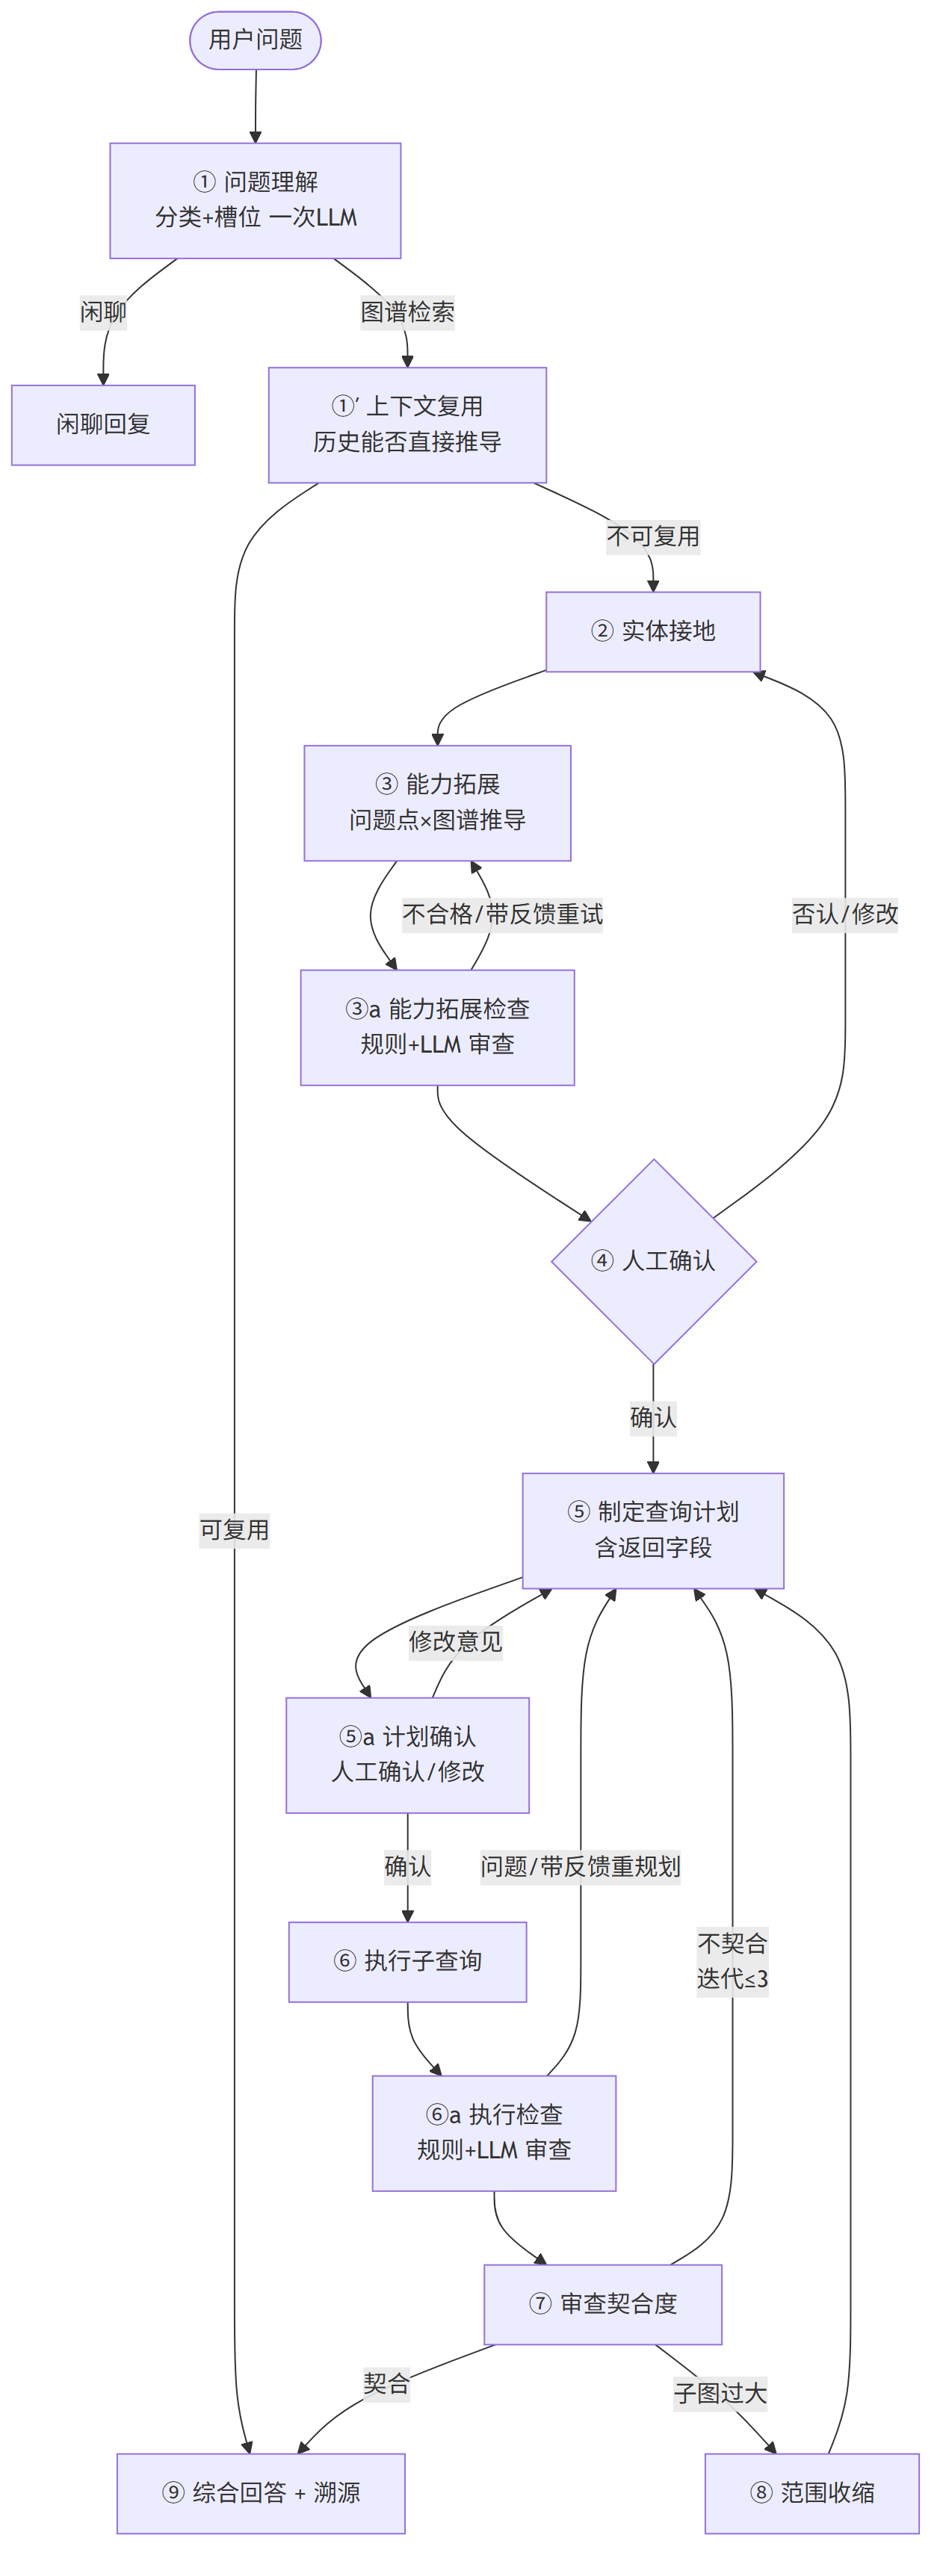
查看 / 编辑 Mermaid 源码
```mermaid graph TB Q([用户问题]) --> N1[① 问题理解分类+槽位 一次LLM] N1 -->|闲聊| N2[闲聊回复] N1 -->|图谱检索| R1[①′ 上下文复用
历史能否直接推导] R1 -->|可复用| N10[⑨ 综合回答 + 溯源] R1 -->|不可复用| N3[② 实体接地] N3 --> C1[③ 能力拓展
问题点×图谱推导] C1 --> CC1[③a 能力拓展检查
规则+LLM 审查] CC1 -->|不合格/带反馈重试| C1 CC1 --> N5{④ 人工确认} N5 -->|否认/修改| N3 N5 -->|确认| N6[⑤ 制定查询计划
含返回字段] N6 --> CP[⑤a 计划确认
人工确认/修改] CP -->|确认| N7[⑥ 执行子查询] CP -->|修改意见| N6 N7 --> RC1[⑥a 执行检查
规则+LLM 审查] RC1 -->|问题/带反馈重规划| N6 RC1 --> N8[⑦ 审查契合度] N8 -->|不契合
迭代≤3| N6 N8 -->|子图过大| N9[⑧ 范围收缩] N9 --> N6 N8 -->|契合| N10[⑨ 综合回答 + 溯源] ```
问答层各节点职责:
| 编号 | 节点 | 输入 → 输出 | 关键逻辑 |
|---|---|---|---|
| ① | 问题理解 understand |
用户问题 + 最近对话 → 分类 + 槽位(一次 LLM 调用) | 闲聊走 chat 结束;图谱检索进入接地;否认确认时携带反馈重新理解 |
| ①′ | 上下文复用 reuse_check + answer_reuse |
当前问题 + 历史轮次 → 能否直接推导 | 仅在有历史轮次时触发;历史包含全部事实则直接回答(标注"基于前序对话推导"),省去重新检索;缺数据/新实体/新筛选 → 走完整检索 |
| ② | 实体接地 ground |
原始槽位 → 接地槽位(锚点→主键/标签/置信度、时间归一化、意图→候选边) | 词法精确/包含/相似度 → Qwen3-Embedding 兜底;高置信度替换主键 |
| ③ | 能力拓展 capability |
问题点 + 元知识图谱结构 → 派生规则(概念/来源字段/表达式/建议参数) | 量化条件/未接地实体/筛选值未对齐 三类问题点触发;LLM 动态推理换算关系,结果注入计划器 |
| ③a | 能力拓展检查 cap_check + cap_llm_check |
派生规则 → 检查报告 | 规则层:表达式可解析/参数与概念一致/表达式引用来源字段;LLM 层仅对未注册新概念审查;不合格带反馈重试(≤3 次) |
| ④ | 人工确认 confirm |
接地槽位 → 自然语言确认文案 | LangGraph interrupt 中断等用户回复;否认带反馈回 ② |
| ⑤ | 制定计划 plan |
问题 + 接地槽位 + 元图谱结构 → 查询步骤图(工具/参数/返回字段/依赖) | 一次 LLM 调用完成规划+字段规划;必须包含派生换算来源字段;执行层再强制并入兜底 |
| ⑤a | 计划确认 confirm_plan |
查询计划表 → 人工确认/修改 | 首次计划与用户修改后的计划需确认;系统自动重试(执行检查/审查反馈)直接执行不打断;派生参数标注换算来源(如 年龄上限 ← 出生日期) |
| ⑥ | 执行子查询 run |
步骤图 → 检索子图(每步实参/丢弃参数/Cypher/行数/溯源) | 参数别名映射 + 工具签名校验;内置 聚合统计 / 缺勤分析;--debug 可看实际查询 |
| ⑥a | 执行检查 run_check + run_llm_check |
子图 → 检查报告 | 规则层:执行失败/未知工具/参数被丢弃/空结果;LLM 层:结果可信度与问题契合度审查;问题带反馈回 ⑤ 重规划(≤3 次) |
| ⑦ | 审查契合度 reflect |
子图 + 接地槽位 → 契合判定 | 规则前置(子图非空且锚点置信≥0.5 直接契合)→ LLM 审查;不契合回 ⑤(≤3 次) |
| ⑧ | 范围收缩 scope |
子图行数 > 30 → 用户选项 → 回 ⑤ | interrupt 中断;同一问题只询问一次(scope_offered 防死循环) |
| ⑨ | 综合回答 answer |
检索子图 + 用户问题 + 图谱结构 → 带溯源回答 | 只依据子图事实,缺失明确说"数据中未找到" |
实现:src/knowledge_agent/agent/graph.py(LangGraph 有向图);scripts/ask.py --debug
可查看每步实际执行的参数与 Cypher(见 6.4)。
4. 知识图谱数据模型
4.1 节点(当前构建器已实现)
| 节点 | 来源部门 | 属性(与模板一致) |
|---|---|---|
| 项目(枢纽) | 市场部 | 编号* / 名称* / 简称 / 上级项目编号 / 续签前项目编号 / 起止时间 / 省份 / 市(区)/ 细分业态 / 汇总业态 / 委托方式 / 计费方式 / 合同面积 / 合同金额 / 年化合同额 / 合同额具体信息 / 服务期限 / 合同状况 / 首次服务日期 / 年化合同收入 / 客户满意度 / 客户投诉 / 甲方名称 / 项目地址 / 项目负责人 / 项目负责人工号* / 实际毛利率 / 服务状态 / 备注 |
| 人员 | 人事部 | 姓名* / 工号* / 组织名称 / 岗位名称* / 当前服务项目编号 / 服务起始-结束年月 / 职级 / 员工层级 / 所属组织名称 / 入职-离职日期 / 司龄 / 性别 / 出生日期 / 政治面貌 / 联系电话 / 备注 |
| 片区 | 运营部 | 片区编号* / 片区名称* / 片区负责人工号* |
| 财务 | 财务部 + 人事部 | 财务类型(项目财务/人员财务)/ 年月;项目财务:开票金额、收款金额、口径;人员财务:餐费/加班超时费/国定加班费/值班费/税后工资 |
| 投标记录 | 市场部 | 项目编号 / 年份 / 投标类型 / 中标结果 / 中标日期 / 投标金额 / 文档路径 |
| 岗位编制 | 运营部 | 项目编号 / 岗位 / 预算编制 / 项目编制 / 标准工时人数 / 在岗人数 |
| 设备 | 运营部 | 项目编号* / 设备编号* / 设备类型 / 名称 / 规格型号参数 / 制造厂商 / 安装位置 / 出厂-启用-入项目-退项目日期 / 出厂编号 / 完好状况 / 原值 / 设备责任人工号* |
| 考勤 | 人事部 | 工号 / 项目编号 / 年月 / 1-31 日状态 / 上班天数 / 加班小时 / 餐费 / 加班费 / 值班费 / 税后工资 |
| 排班月报 | 人事部 | 工号 / 项目编号 / 年月 / 1-31 日班次 |
| 供应商 | 采购部 | 名称 / 编号 / 类别 |
| 维保合同 | 采购部 | 项目编号 / 名称 / 类别 / 合同年限 / 金额 / 月份或日期 |
| 采购记录 | 采购部 | 记录类型(耗材采购/固定资产)/ 项目编号 / 名称 / 数量 / 单价 / 金额 / 状态 |
| 检查记录 | 运营部 | 项目编号 / 检查类型 / 检查日期 / 检查得分 / 问题描述 / 整改情况 / 整改完成日期 |
| 证书 | 人事部 | 工号 / 证书名称 / 专业类别 / 证书类别(保安员(三级)、高压电工作业、物业管理师等) |
规划中(暂未入模板/构建器):科目余额(财务科目,模板已移出,系统侧扩展)、月度快照(聚合层,后续生成)。
4.2 关系(边)
| 起点 | 终点 | 关系 | 时间语义 | 关联键 |
|---|---|---|---|---|
| 人员 | 项目 | 服务于 |
期间边(开始/结束) | 工号 + 项目编号(直接填写 + 考勤/排班连续月份推导) |
| 项目 | 项目 | 包含 |
静态层级 | 上级项目编号(父→子) |
| 项目 | 项目 | 续签自 |
续签链 | 续签前项目编号(新-续签自-旧) |
| 项目 | 片区 | 属于片区 |
M:N 静态 | 项目编号 + 片区编号 |
| 片区 | 人员 | 负责人 |
静态 | 片区负责人工号 |
| 项目 | 人员 | 负责人 |
静态 | 项目负责人工号 |
| 项目 | 投标记录 | 投标 |
年份 | 项目编号 + 年份 |
| 投标记录 | 人员 | 经办人 |
静态 | 投标经办人工号 |
| 项目 | 采购记录 | 采购 |
月份/日期 | 项目编号 |
| 采购记录 | 供应商 | 供应商 |
静态 | 供应商名称 |
| 采购记录 | 人员 | 经办人 |
静态 | 经办人工号 |
| 项目 | 维保合同 | 维保 |
合同期 | 项目编号 |
| 维保合同 | 供应商 | 维保单位 |
静态 | 维保单位名称 |
| 维保合同 | 人员 | 经办人 |
静态 | 经办人工号 |
| 项目 | 岗位编制 | 编制 |
静态/年度 | 项目编号 + 岗位 |
| 人员 | 考勤 | 有考勤 |
月事实边 | 工号 + 年月 |
| 考勤 | 项目 | 所属项目 |
月事实 | 项目编号 + 年月 |
| 人员 | 排班月报 | 有排班 |
月事实边 | 工号 + 年月 |
| 人员 | 证书 | 持有 |
静态 | 工号 + 证书名称(一人多张) |
| 排班月报 | 项目 | 所属项目 |
月事实 | 项目编号 + 年月 |
| 项目 | 财务 | 月度财务 |
月事实边 | 项目编号/工号 + 年月 |
| 人员 | 财务 | 月度财务 |
月事实边 | 工号 + 年月 |
| 财务 | 人员 | 经办人 |
静态 | 财务经办人工号 |
| 项目 | 检查记录 | 检查 |
检查日期 | 项目编号 |
| 检查记录 | 人员 | 检查人 |
静态 | 检查人工号 |
| 设备 | 项目 | 所属项目 |
静态/入项目日期 | 项目编号 + 设备编号 |
| 设备 | 人员 | 责任人 |
静态 | 设备责任人工号 |
4.3 时间建模原则
- 图只建一份,不按时间切片;时间是关系/事件属性,查询时谓词下推。
- 期间边(
服务于)表达人员跨项目流动:一人多条边,如KWL2307024= 赵巷镇政府(2026-01~02) + 青浦-北斗园区(2026-03~04)。 - 时间段查询用区间相交:
开始 <= 目标月 AND 结束 >= 目标月;月度事实用年月相等。 - 财务节点以
财务类型 + 年月为时间键;考勤/排班以工号 + 项目编号 + 年月为键。 - 月度快照(规划)是聚合层:时间段汇总先打快照,明细按需下钻,控制检索边界与上下文大小。
4.4 数据对齐规则
- 项目编号唯一性:项目编号为全局唯一键(模板必填)——续签项目的名称/简称可能相同, 但编号一定不同;所有明细表一律以项目编号关联项目,项目名称仅作可读性核对。
- 工号唯一性:人员以工号(KWL 前缀)为全局唯一键(模板必填);历史缺工号数据按 姓名+项目+月份消歧。
- 岗位名称规范:人员「岗位名称」与「岗位编制」的岗位用同一套规范名(如 保安_领班); 员工层级为岗位所属分类(一线员工/项目管理人员等),由岗位字典映射校验。
- 当事人必填:凡涉及人的工作记录必须带工号(项目负责人、检查人、投标/采购/财务经办人、 设备责任人、片区负责人),保证"每件事都能找到当事人";构建时校验工号存在于人员主表。
- 项目-片区(M:N):一个项目可属于多个片区,经「项目片区关系」表建模,生成
(项目)-[:属于片区]->(片区)边;片区负责人挂在片区节点上,避免在每个项目行重复填写。 - 业务大表对齐:业务大表项目名为简称(无金蝶编码),需经别名表映射到市场部主数据;
从属关系判定双信号:序号(
5父、5-1子)+ 委托方式(全委/多项单委/单一单委 = 正式项目行)。 - 续签链:项目主表"续签前项目编号"填上一期编号生成
续签自边;档案目录 (区域→项目→合同期文件夹)由scripts/analyze_renewal_folders.py扫描生成output/续签链-档案目录.csv回填,目录编号与金蝶编码存在对应规律(102 → XMSQ0102)。 - 排班项目归属:文件名分组 + 组织代码 × 考勤交叉比对(43/48 唯一确定);人事架构表到位后补全。
- 字段名写死:构建器按模板字段名严格读取,字段名不一致即报"缺少模板必填字段"。
- 所有节点/边带溯源(来源模板类别 + 文件 + 行号)。
4.5 Neo4j 约束与索引
- 唯一约束:项目.编号、人员.工号、片区.编号;设备 (项目编号, 设备编号) 节点键。
- 导入策略:MERGE 幂等,可全量重建;构建分两阶段(先节点后关系),避免顺序依赖。
4.6 数据模板(15 类,每份一个数据表 + 填写说明)
| 模板 | 必填列 | 字段依据 |
|---|---|---|
| 项目信息 | 项目编号 / 项目名称 / 项目负责人工号 | 字段依据表标注来源文件+列名;新增融合字段标注"新增(融合)" |
| 项目月度财务 | 项目编号 / 年月 / 财务经办人工号 | 同上 |
| 投标记录 | 项目编号 / 年份 / 投标经办人工号 | 同上 |
| 人员信息 | 姓名 / 工号 / 岗位名称 | 同上 |
| 考勤与人员财务 | 姓名 / 工号 / 项目编号 / 年月 | 同上(1-31 日状态代码含义见说明) |
| 排班月报 | 姓名 / 工号 / 项目编号 / 年月 | 同上(1-31 日班次代码 + 常用对照见说明) |
| 岗位编制 | 项目编号 / 岗位 | 同上 |
| 设备信息 | 项目编号 / 设备编号 / 设备责任人工号 | 同上 |
| 采购与维保 | 记录类型 / 项目编号 / 经办人工号 | 同上(供应商/维保合同/耗材采购/固定资产四类共用) |
| 检查记录 | 项目编号 / 检查人工号 | 同上 |
| 片区信息 | 片区编号 / 片区名称 / 片区负责人工号 | 同上 |
| 项目片区关系 | 项目编号 / 片区编号 | 同上 |
| 人员证书 | 工号 / 证书名称 | 同上(登记表申勤 sheet 缺工号,需按姓名在花名册补全) |
模板生成脚本:scripts/generate_templates.py;字段来源说明由该脚本生成模板时维护。
5. 数据构建管线(graph/ 模块)
5.1 输入
用户提供 13 个文件数组(每类可多份 Excel),如 data/config_example.json:
{"项目信息": [文件...], "项目月度财务": [...], ...};CLI:uv run python scripts/build_graph.py 配置.json [--clear]。
5.2 校验(reader.py)
- 字段名写死校验:文件必须包含模板必填字段名,缺失即报错;
- 必填值、日期/年月/金额格式解析(pydantic);
- 读取问题逐条记录(类别/文件/行号/原因)。
5.3 构建(builder.py,两阶段)
- 阶段一:创建全部节点(项目/人员/考勤/排班月报/财务/投标记录/岗位编制/设备/
供应商/维保合同/采购记录/检查记录/片区),并为节点补
display显示属性; - 阶段二:创建全部关系(含当事人边、服务期直接填写 + 连续月份推导);
- 校验:引用存在性(缺项目/人员/片区/经办人/责任人等)→ 警告清单。
5.4 月度快照(规划)
- 聚合口径:
groupby(项目, 年月),在岗人数 = 当月去重工号数; - 财务字段由项目财务节点聚合(开票/收款分存,口径待财务确认);
- 全量重算覆盖(规模小,秒级)。
5.5 DMS 数据 → 模板 合并(数据接入管线)
最终目标:DMS 已有数据 + 员工人工补填 → 生成 15 类模板样式文件 → 图谱构建。
模板字段按来源分三类(见 docs/DMS字段映射_最新范围.md):
| 来源类型 | 含义 | 处理方式 |
|---|---|---|
| DMS来源 | DMS 模型中有对应字段 | 系统自动拉取(需有效 token) |
| 源Excel搬运(DMS未建模型) | 源 Excel 有、DMS 无模型(考勤/排班/设备/检查/月度财务等) | 人工从源文件搬运到模板 |
| 新增融合 | DMS 与源 Excel 均无,为图谱关联/可读性添加 | 人工确认填写(工号/项目编号/片区编号等) |
人工补填清单:data/manual_fill/DMS补数字段清单.csv
(生成脚本 scripts/generate_dms_supplement.py),列出全部需人工补填字段:
51 个源Excel搬运 + 25 个新增融合,逐字段标注来源文件+列、与 DMS 的对齐键、是否必填。
合并流程:
- DMS 拉取:按字段映射从 16 个申勤模型(sq_project / sq_employee / shenqin_txb / xzbm /
sq_personnel_certificate / sq_position_salary 等)拉取 DMS来源 字段;
token 过期时需从 DMS 控制台重新复制
vuejs_token(存.env)。 - 人工补填:按补填清单分工——源Excel搬运 = 从源文件复制对应列;新增融合 = 人工确认填写。
- 合并:以各模板「对齐键」(如 项目信息=项目编号,考勤=工号+项目编号+年月,设备=项目编号+设备编号)为键, DMS 数据行与人工补填数据行 merge 成完整模板行;键相同则合并,人工列缺失则报错。
- 校验:复用
graph/reader.py——字段名写死校验、必填校验、引用存在性校验(缺项目/人员/片区/经办人/责任人给出警告清单)。 - 构建:
scripts/build_graph.py读模板文件 → Neo4j 两阶段构建。
已知数据坑:
- 考勤「税后工资」源表无列名,赵巷公园等文件月度工资额填在表头为「员工签字」的列(如 4896.25)。
- 考勤/排班「备注」:考勤来自考勤表「备注」列;排班文件无备注列,为新增融合。
- 人员「当前服务项目编号」DMS 仅有项目名称(五级公司),编号需人工映射。
- DMS 中无考勤/排班/设备/检查/月度财务模型,这几类几乎全部依赖人工搬运。
6. 检索与问答
6.1 槽位 Schema(已实现:agent/nodes.py fill_slots)
class QuerySlots(BaseModel):
    raw_question: str
    projects: list[str]                    # 原始项目表述
    time_range: TimeRange | None           # 归一化年月范围
    intent: Intent                         # 考勤/排班/收费/设备/服务期/汇总对比/组合
    granularity: Literal["汇总", "明细"]    # 默认 汇总
    filters: dict[str, str]                # 部门/岗位/设备类型等
命名实体走相似度接地;时间走归一化+范围匹配(注入当前日期解析相对时间,图内覆盖 2026-01~04,超出诚实回答);意图/粒度走模板映射。槽位抽取会带入最近 4 条对话 上下文(上下文记忆);用户在确认环节否认时,反馈会回到槽位抽取重抽。
6.2 实体索引与接地(已实现:retrieval/entity_index.py、grounding.py)
- 内存索引:项目(编号/简称/名称/地址/甲方)、人员(工号/姓名/岗位)、设备(编号/名称)、片区(编号/名称);
- 匹配层级:归一化精确 → 包含 → difflib 编辑相似度;同名续签项目按"服务中"优先;
- 输出候选 + 置信度(1.0 精确 / 0.75+ 包含 / 模糊),高置信度替换为主键,低置信度返回候选让用户确认;
- 词法未命中时用 Qwen3-Embedding-0.6B 相似度兜底(top-3,≥0.55 视为命中,低于阈值标
ambiguous); - 接地记录(原词 → 标准属性 → 主键 → 置信度)用于溯源。
概念接地(agent/concepts.py):实体接地解决"具体名称→节点主键",概念接地解决
"泛化表述→图谱概念(节点/属性/工具)"。用户问题中的 员工/在职年限/人数 等表述,经
同义词子串精确命中 + embedding 相似度兜底,映射到 人员节点/司龄属性/人员工具+count,
结果注入计划器提示词(plan 节点的"用户问题概念解析"),避免"用户说法 ≠ 图谱命名"
导致工具选错(如把人数统计选成服务期)。概念与同义词集中维护在 concepts.py,可扩展。
值接地(agent/value_grounding.py):概念接地管"用户说法→节点/属性/工具",值接地管
"用户筛选词→字段枚举值"。用户说"管理岗"而图谱岗位名称是"项目经理",或"保安"对应
"保安_领班/保安_普保";值接地从图谱加载各字段 distinct 值,先精确/包含匹配,再用
embedding 相似度选 top-k 规范值(ground 节点输出 filters_grounded),计划器用规范值
调用工具(人员(岗位=["项目经理",...])),查询工具支持列表参数(IN 匹配)。
派生属性与能力拓展(agent/derived.py + nodes.extend_capability):图谱只存原始属性 (出生日期/项目起止时间),用户问派生概念(年龄/剩余服务期)。两条路径:
- 快速路径:
derived.py声明式规则(RULES:年龄←出生日期、剩余服务期←项目起止时间), 数值条件解析把"50岁以下/3个月内到期/满10年"识别为逻辑参数(年龄上限=50); - 动态路径(能力拓展节点):检测到问题点无法直接对应图谱节点/属性时,
extend_capability把"问题点 + 元知识图谱结构"交给 LLM,动态推理换算关系,输出 概念名/来源字段/表达式/建议参数; 计划器据此制定计划,执行层用通用表达式求值器eval_expr(白名单 AST:today/years_between/ months_between/to_number/replace 与四则运算)在 Python 侧换算过滤。
新派生概念无需预注册:已注册规则只是性能快速路径,未知概念(月均成本、续签次数、 人均产值…)由能力拓展节点动态发现;工具与提示词无需逐例修改。
按需返回字段(agent/nodes.py plan_fields + retrieval/templates.py TOOL_FIELDS):
查询工具的 RETURN 字段从写死改为按问题定制——字段规划节点(LLM,需元图谱结构)
为每个步骤选择必要字段,减少返回规模。与能力拓展配合:字段规划必须包含派生换算的
来源字段(source_fields),且执行层 make_and_run 会强制把派生参数对应的来源字段
并入返回列(如 年龄←出生日期 时"出生日期"必然返回),不依赖 LLM 正确性,避免漏字段。
SCHEMA_TEXT 单一事实源(meta/schema.py):问答 LLM 看到的节点/关系结构不再手写,
由 meta/schema.py 的 ENTITIES/RELATIONS 自动生成(未入图实体用 active=False 过滤)。
工具清单、派生清单、字段清单均挂接同一来源,改图谱模型只改 meta,问答提示词自动同步。
数据时间覆盖动态化:SCHEMA_TEXT 每次问答动态组装,年月覆盖从图谱实时统计
(考勤节点 min/max 年月,TTL 缓存 60s,Neo4j 不可用时回退静态默认值),
图谱重建到新月份后计划器自动感知,不再写死。
能力拓展触发泛化(nodes._capability_trigger):不再只限量化条件,三类问题点都会触发 能力拓展:① 量化条件(50岁以下/3个月内/满10年,纯时间如"3月"不触发);② 未接地实体 (锚点未能匹配图谱节点);③ 筛选值未对齐(filters 值接地低置信/ambiguous)。
6.3 查询模板工具集(已实现:retrieval/templates.py)
| 工具 | 输入 | 输出 |
|---|---|---|
query_attendance |
项目编号/年月/工号 | 考勤记录 + 溯源 |
query_schedule |
项目编号/年月 | 排班月报 + 溯源 |
query_finance |
项目编号/年月/财务类型 | 项目/人员财务 + 溯源 |
query_equipment |
项目编号/设备类型 | 设备台账 + 溯源 |
query_service_period |
工号/项目编号 | 服务期边记录 |
query_project_children |
项目编号 | 从属子项目 |
query_project_renewals |
项目编号 | 续签链 |
query_certificates |
工号/项目编号/专业类别 | 持证记录 |
内置汇总工具(非图谱查询,由执行节点计算):聚合统计(sum/avg/count/max/min)、
缺勤分析(服务期在册 vs 考勤出勤,输出 在册/考勤/缺勤人数 + 人员明细)、
项目缺口分析(服务中但无人员服务记录的项目)、交集分析(跨步骤按条件过滤后
取关键字段交集,如 连续N个月都有加班 = 查N个月考勤 + 行过滤 平时加班>0 + 工号交集)。
时间谓词在 Cypher 内下推;输出结构化结果 + 来源说明;每次执行回传实际
Cypher 与参数(QueryResult.query/query_params),供 --debug 输出。
6.4 Agent 编排(已实现:agent/graph.py Plan→Run→Reflect)
- Plan:LLM 依据 用户问题 + 接地槽位 + 元图谱结构(SCHEMA_TEXT)拆解子查询,
选择工具、定执行顺序与依赖(
depends),参数用接地后的主键(项目编号/工号/年月); - Execute(run):解析步骤间
$引用 → 参数别名映射(项目编号→project_code 等) → 校验工具签名,记录 实参(executed_params)/ 被丢弃参数(dropped_params) (被丢弃即字段名不匹配,可直接暴露检索问题)→ 执行并回传 Cypher/参数/行数/溯源; - Reflect:规则前置——子图非空且锚点全部高置信度接地(≥0.5)直接判契合,避免无谓循环; 否则 LLM 审查(锚点/时间/意图覆盖、空结果区分"参数错"与"数据没有"、是否需聚合); 迭代 ≤3 轮,超限诚实作答;
- 双层检查(能力拓展 + 执行):每个环节先规则检查(表达式可解析/字段引用/参数一致性; 执行失败/丢弃参数/空结果),再 LLM 语义审查(换算关系与参数方向、结果可信度与问题契合度), 不合格带反馈回对应环节重试(capability/plan,各 ≤3 次),报告写入 state 并可在 CLI 输出看到;
- 范围收缩:子图行数 > 30 时经
scope中断给用户选项,选择后回计划重查 (同一问题只询问一次,scope_offered防死循环); - 只读保障:所有问答 LLM 提示词注入 SYSTEM_SAFETY(禁止修改图谱数据);
- 防重试风暴:SCHEMA_TEXT 注入数据时间覆盖(2026-01~04),计划器不会凭空生成覆盖外 年份;空参数(项目编号/工号 空串)禁止;执行 LLM 审查对"数据确实没有/覆盖外"判 ok 诚实回答,只有明确可修复错误才触发重规划,避免 0 行结果引发多轮 LLM 重试循环;
- 调试:
scripts/ask.py --debug输出每步 实参/丢弃参数/Cypher/参数/首行, 状态全程记录 trace(classify/slots/ground/plan/run/reflect/answer 各节点日志)。
6.5 人工确认与上下文记忆(已实现:human-in-the-loop)
- 槽位确认节点:接地后把查询意图翻译回自然语言(意图/对象/时间/筛选/粒度),
通过 LangGraph
interrupt中断等用户确认;否认时带用户反馈回到槽位填充重抽; - 计划确认节点:计划器生成查询计划表(步骤/工具/参数/依赖)后
interrupt打印给用户, 确认后执行;用户可直接说修改意见("去掉第2步""改用项目列表工具"),反馈回计划器重规划; 派生参数会标注换算来源("年龄上限=50(年龄由出生日期换算)"),中间换算逻辑由 计划器/能力拓展器内部消化,不暴露为多步;系统自动重试(执行检查/审查反馈)不再打断用户, 只在首次计划与用户主动修改后确认,避免重复确认; - 范围收缩节点:Reflect 检测到子图行数 > 30 时,中断给用户选项
(只看某项目 / 按岗位筛选 / 汇总口径 / 继续返回全部),选择后回到计划节点重查;
同一问题只询问一次(
scope_offered防死循环); - 上下文记忆:LangGraph checkpointer(thread_id)+ messages 历史,支持多轮 (如"改成4月""换成税务局");槽位抽取会带入最近对话上下文;
- 上下文复用:多轮中当前问题若可由历史轮次直接推导(如上一轮已列出各月考勤,
这轮问"连续三个月都有加班的人"),
reuse_check判定可复用后由answer_reuse直接回答(标注"基于前序对话推导"),不重复检索,省 2~3 次 LLM 调用与全部查询; 历史数据不足或涉及新实体/时间/筛选时回退完整检索; - CLI:
uv run python scripts/ask.py交互模式;--auto自动确认(批处理/评测用);--debug显示每步实际执行的 实参/丢弃参数/Cypher/首行(检索字段名排查)。
6.6 回答与溯源规范
- 回答使用图内标准名称(如 "青浦-区图书馆(XMSQ0102)");
- 每个事实标注来源(模板类别 + 文件 + 行号);无法回答时明说原因。
6.7 API 服务(FastAPI,src/knowledge_agent/api.py)
启动:uv run python -m knowledge_agent.api(默认 127.0.0.1:8000)。
| 接口 | 说明 |
|---|---|
POST /ask |
body {thread_id, query, auto_confirm};graph.astream 异步收集后返回完整结果;遇人工确认时按 auto_confirm 自动确认或返回 need_confirm |
POST /ask/stream |
SSE:event: progress(节点级进度,answer 节点带答案)、event: confirm、event: done(完整结果) |
POST /threads/{id}/resume |
body {reply};恢复被中断会话(确认或修改意见),再次中断则返回 need_confirm |
GET /threads/{id}/history |
返回该会话的 rounds(问题/实体/回答)与 messages |
设计要点:
- 底层流式:
agent/llm.py的chat_json/chat_text全部用llm.stream()收集(无 invoke), 预留on_chunk回调,后续可升级为 token 级透传; - 全异步 astream:/ask 与 /ask/stream 共用
_astream_run事件流(节点级进度 + interrupt 循环), resume 走_astream_resume,同一套逻辑,无 invoke/stream 双实现; - 并发:全局共享一个 compiled graph +
InMemorySaver,状态按thread_id隔离, FastAPI async +graph.astream天然支持多请求并发; - 上下文记忆:仍为内存(
InMemorySaver),后续持久化/图数据库化时替换api.py的 checkpointer 初始化与ask.py的_make_checkpointer()即可。
7. 代码结构
knowledge_agent/
├── pyproject.toml / uv.lock
├── .env                     # NEO4J_* / DEEPSEEK_*(不入库)
├── docs/技术方案.md
├── data/
│   ├── templates/           # 15 类单表模板(+填写说明)
│   ├── test_data/           # 与模板一一对应的测试数据
│   ├── manual_fill/         # 人工补填清单(DMS 无模型字段的填写任务)
│   └── config_example.json  # 15 类文件数组示例配置
├── src/knowledge_agent/
│   ├── config.py
│   ├── meta/                # 元知识图谱(schema/builder/render)
│   ├── graph/               # 全量图谱构建:schemas/reader/builder/pipeline
│   ├── retrieval/           # 实体索引/接地/模板工具集(已实现)
│   └── agent/               # LangGraph:分类/槽位/接地/确认/计划/执行/审查/范围/问答
├── scripts/
│   ├── generate_templates.py / generate_test_data.py
│   ├── generate_dms_supplement.py                      # DMS 补数字段清单
│   ├── export_meta_schema.py                           # 元知识图谱 JSON 导出
│   ├── build_graph.py       # CLI 图谱构建
│   ├── test_retrieval.py    # 检索层冒烟测试
│   ├── ask.py               # 交互式问答 CLI(含确认/范围收缩)
│   └── analyze_*.py         # 档案/排班归属等分析
└── output/                  # 生成物(续签链清单等,gitignore)
8. 实施计划与状态
| 阶段 | 内容 | 状态 |
|---|---|---|
| P0 数据准备 | 项目别名表、组织代码映射、档案目录续签链、口径清单 | 部分完成(续签链/排班归属分析脚本就绪) |
| P1 全量图谱 | 15 类模板解析 + 两阶段构建 + 校验 + CLI | ✅ 已实现,测试数据端到端跑通 |
| P2 实体索引 | 内存索引 + 分层匹配 + 置信度 + 服务中优先 | ✅ 已实现 |
| P3 模板工具集 | 查询函数 + 聚合统计/缺勤分析 + LLM 槽位抽取(DeepSeek JSON) | ✅ 已实现(6.1-6.3) |
| P4 Agent 检索 | Plan/Execute/Reflect + trace + 槽位确认/范围收缩/上下文记忆 + --debug | ✅ 已实现(CLI 交互 + --auto/--debug) |
| P5 接口评测 | CLI→API、评测集(20-30 题:正确率/溯源率/空答率) | 待做 |
| P6 安全与权限 | 权限检查接线、敏感字段脱敏、审计日志、API 认证与限流 | 部分就绪(见第 11 章) |
9. 已确认的默认决策
- 模板结构:15 类、每份一个数据表(避免多 sheet 跨表填写);关联用 项目编号/工号 必填;
- 当事人必填:项目负责人、检查人、投标/采购/财务经办人、设备责任人、片区负责人 均需工号;
- 岗位名称与岗位编制统一规范名;员工层级为分类(岗位字典映射校验);
- 财务口径:开票/收款分字段存储,口径待财务确认;
- 工单/维保图片:本阶段不 OCR 入库(后续扩展);
- 问答入口:先 CLI,后续 FastAPI;
- 优先场景:排班考勤 + 收费汇总,验证后扩展设备/满意度等;
- 排班归属:考勤交叉比对推断,人事架构表到位后补全;
- 字段名写死:实际数据严格按模板字段填写,构建器严格校验。
10. 数据质量风险与应对
| 风险 | 应对 |
|---|---|
| 项目名写法不统一/续签同名 | 项目编号唯一键 + 别名表 + 接地"服务中优先" |
| 人员重名 | 工号唯一键 + 当事人工号必填 |
| 岗位名称不统一 | 与岗位编制统一规范名 + 岗位字典校验 |
| 排班组织代码归属推断误差 | 按月细分 + 架构表补全;低置信度询问 |
| 财务口径不确定 | 开票/收款分字段存储并标注 |
| 模板字段名与数据不一致 | 字段名写死校验,缺失即报错 |
| 引用工号/编号不存在 | 构建后引用存在性校验 + 警告清单 |
| 图片数据未入库 | 该域问题明确回答"数据未入库" |
11. 安全与权限方案
本方案独立成章,后续新增安全处理统一在此登记,并在 11.2 威胁表中补一行、在 11.5 扩展清单中补一项。 每项安全控制必须标注状态:✅ 已实现 / 🟡 待接线(代码或配置已就绪,未接入流程)/ ⬜ 规划中。
11.1 安全原则
- 只读优先:问答阶段图谱只读;任何数据修改只能通过专门的权限流程(当前仅图谱构建阶段可写)。
- 最小权限:按「角色 × 意图」授权,默认拒绝(
guest仅开放考勤/排班);敏感意图单独管控。 - 数据分级:工资、联系方式、政治面貌等敏感字段按角色脱敏,默认不对外输出。
- 全程可审计:问题 → 槽位 → 接地 → 计划 → 子图 → 回答全链路留痕,可回放、可追责。
- 凭据不入库:Neo4j / DeepSeek / DMS 凭据走环境变量(.env),不入代码、不进仓库。
11.2 威胁模型与防护目标
| 威胁 | 场景 | 防护措施 | 状态 |
|---|---|---|---|
| 数据篡改 | 用户诱导 LLM 修改/删除图谱数据 | SYSTEM_SAFETY 注入所有问答提示词 + Neo4j 只读账号(规划) | ✅ / ⬜ |
| 越权查询 | staff 查询工资、收费数据 | 权限矩阵拦截(permission_check 节点)+ 敏感字段脱敏 | 🟡 |
| 敏感信息泄露 | 回答中出现税后工资/电话/政治面貌/身份证 | 敏感意图 + 敏感字段双级脱敏 | 🟡 |
| 提示词注入 | 用户输入试图覆盖系统指令 | 系统提示词边界 + 输入规范化 + 输出校验(规划) | ⬜ |
| 幻觉/错误回答 | LLM 编造图谱外数据 | answer 只依据检索子图 + 溯源 + 缺失明说"数据中未找到" | ✅ |
| 凭据泄露 | .env / DMS token 进入仓库或日志 | gitignore + 环境变量 + token 轮换(DMS token 待移入 .env) | 🟡 |
| 接口滥用 | 高频调用刷接口、恶意批量查询 | API 认证(JWT)+ 限流/配额(规划) | ⬜ |
11.3 已实现的安全控制(✅)
- 只读保障(SYSTEM_SAFETY)
- 位置:
src/knowledge_agent/agent/llm.py; - 机制:
chat_json/chat_text对所有问答 LLM 调用自动拼接安全约束,禁止修改/写入/删除图谱或业务数据; - 覆盖:分类、槽位、计划、审查、回答、闲聊全部节点。
- 位置:
- 溯源与诚实回答
- 位置:
agent/nodes.pyanswer 节点; - 机制:回答只依据检索子图事实,缺失明确说"数据中未找到",金额带单位、人名/项目用标准名称。
- 位置:
- 凭据管理
- 位置:
.env(gitignore 排除)+src/knowledge_agent/config.py; - 机制:Neo4j / DeepSeek 连接信息从环境变量读取;
.env.example仅含占位值。
- 位置:
11.4 权限模型(🟡 数据就绪,待接线)
配置文件:data/permissions.json(角色、用户、敏感项,JSON 便于后续接入 API 时按请求携带权限)。
角色 × 意图矩阵:
| 角色 | 考勤 | 排班 | 设备 | 服务期/从属/续签 | 证书 | 收费 | 工资 |
|---|---|---|---|---|---|---|---|
| admin | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| manager | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| staff | ✅ | ✅ | ✅ | ✅ | ✅ | ❌ | ❌ |
| guest(默认) | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ |
sensitive_intents:收费、工资(命中即需权限校验);sensitive_fields:税后工资、加班超时费/国定加班费/值班费、餐费、联系电话、政治面貌、身份证号码等(无权限时从结果中剔除)。
待接线内容:
permission_check/denied节点已定义(agent/nodes.py),尚未挂入 LangGraph 图;- 计划接线位置:
confirm节点之后、plan之前(意图级拦截); PermissionManager.strip_sensitive在answer前对检索子图执行字段脱敏;user_id传递链:CLI--user→ API 化后由调用方从 token 解析传入。
11.5 安全增强扩展清单(后续新增在此登记)
| 编号 | 项目 | 目标 | 位置 | 状态 |
|---|---|---|---|---|
| S-1 | 权限检查接入图 | 意图级授权拦截,未授权返回明确拒绝信息 | graph.py + nodes.permission_check/denied |
🟡 |
| S-2 | 敏感字段脱敏接线 | 无收费/工资权限的角色看不到敏感金额与个人信息 | nodes.answer 前调用 strip_sensitive |
🟡 |
| S-3 | 审计日志 | 每次问答落盘(thread/问题/槽位/接地/计划/子图/回答/耗时/提问人),支持回放与追责 | scripts/ask.py / API 层 + output/audit/ |
⬜ |
| S-4 | 输入安全 | 防提示词注入:输入规范化、恶意指令检测、系统提示词边界强化 | agent/llm.py + 输入预处理 |
⬜ |
| S-5 | 输出安全 | 回答后校验:不输出敏感字段、不产生"已修改/已删除"类误导 | nodes.answer 后处理 |
⬜ |
| S-6 | Neo4j 只读账号 | 问答用只读凭据,构建用写凭据,账号级隔离写权限 | .env + config.py + retrieval/templates.py |
⬜ |
| S-7 | DMS token 管理 | 把硬编码 token 移入 .env,到期提醒/自动刷新 |
scripts/generate_dms_supplement.py |
🟡 |
| S-8 | API 认证与限流 | FastAPI + JWT,user_id 从 token 取;角色映射;限流/配额 |
API 层(规划) | ⬜ |
| S-9 | 敏感字段清单维护 | 集中维护敏感字段/意图,增删一处生效 | data/permissions.json |
✅ |
11.6 安全相关文件
| 文件 | 作用 |
|---|---|
data/permissions.json |
权限配置:角色/用户/敏感意图/敏感字段 |
src/knowledge_agent/agent/permissions.py |
PermissionManager:角色解析、意图校验、字段脱敏 |
src/knowledge_agent/agent/llm.py |
SYSTEM_SAFETY 只读约束 |
src/knowledge_agent/agent/nodes.py |
permission_check / denied 节点(待接线) |
.env / .env.example |
凭据(Neo4j / DeepSeek / 后续 DMS token) |
scripts/generate_dms_supplement.py |
DMS 补数字段清单生成(token 待移入 .env) |